


Crawl Budget Nədir?
Crawl budget (tarama büdcəsi) — Google-un müəyyən bir sayta müəyyən bir zaman çərçivəsində ayırdığı tarama (crawling) kapasitesidir. Başqa dillə desək, Google-un robotlarının — Googlebot adlanır — saytınızı nə qədər tez-tez və nə qədər dərindən gəzəcəyini müəyyən edən limitdir.
Crawl budget-i daha aydın anlamaq üçün bir analogiya çəkək. Böyük bir kitabxana düşünün — içərisində milyonlarla kitab var. Kitabxanaçı hər kitabı oxuyub kataloqa əlavə etmək istəyir, lakin vaxtı məhduddur. Gündə 1.000 kitab oxuya bilir. Bu kitabxanaçı hər gün hansı kitabları oxuyacağına qərar verəlidir — ən vacib, ən yeni, ən dəyərli olanlardan başlayır. Google da eyni şəkildə işləyir — hər sayta müəyyən bir tarama kapasitəsi ayırır, bu kapasitə daxilindəki səhifələri tarayır, qalanlarını sonraya qoyur.
Crawl budget SEO -nun ən texniki, lakin eyni zamanda ən vacib anlayışlarından biridir. Saytınızdakı səhifə sayı artdıqca, crawl budget idarəetməsi getdikcə kritik əhəmiyyət kəsb edir. Kiçik saytlar üçün bu anlayış adətən problem yaratmır — lakin böyük e-commerce platformaları, xəbər saytları, kataloq saytları üçün crawl budget düzgün idarə edilmədikdə ciddi SEO problemlərə gətirib çıxara bilər.
Crawl Budget Niyə Mövcuddur?
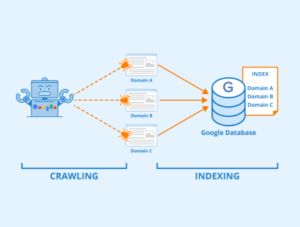
Google dünyada milyardlarla saytı taramalıdır. Bu astronomik bir rəqəmdir — hər sayta sonsuz resurs ayırmaq texniki cəhətdən mümkün deyil. Google məhdud server resurslarını dünya üzərindəki bütün saytlar arasında bölüşdürməlidir. Bu bölüşdürmənin bir sayta düşən payı — crawl budget-dir.
Bundan əlavə, Google saytınızı tararaq serverinizə yük yaradır. Həddindən çox tararsa, saytınızı yavaşlada bilər, bəzən çökdürə bilər. Crawl budget sistemi həm Google-un resurslarını, həm də sayt sahiblərinin server resurslarını qoruyur.
Google-un rəsmi açıqlamasına görə crawl budget iki əsas amildən ibarətdir: crawl rate limit (tarama sürəti limiti) — Google-un saytınızı nə qədər sürətlə tarayacağı — saytın serveri bu yükü kaldıra biləcəkmi? Crawl demand (tarama tələbi) — Google-un saytınızı nə qədər tez-tez taramaq istədiği — saytın populyarlığı, yeniləmə tezliyi, indekslənmə tərəfindən müəyyən edilir.
Crawl Budget Hansı Saytlar üçün Vacibdir?
Google-un rəsmi açıqlamasına görə crawl budget əsasən böyük saytlar üçün vacibdir. Kiçik saytlar — yüzlərlə ya da bir neçə minlik səhifəsi olan saytlar — üçün crawl budget adətən problem yaratmır. Çünki Google bu saytları tam şəkildə tara bilir.
Lakin aşağıdakı vəziyyətlərdə crawl budget aktual məsələyə çevrilir. Onlarla, yüzlərlə minlik URL-i olan böyük [e-commerce →] saytları hər məhsul, hər kateqoriya, hər filtr kombinasiyası üçün ayrı URL yaradır — bu URL sayı milyonlara çıxa bilər. Xəbər portalları hər gün yüzlərlə yeni məqalə əlavə edir — köhnə məzmunun da tazalanması tələb olunur. Avtomatik URL generasiyası olan platformalar — axtarış parametrləri, sıralama filtrləri, sessiya ID-ləri — crawl budget-i boşa xərcləyə bilər. [SEO audit →] zamanı crawl budget idarəetməsi mütləq yoxlanılmalı olan elementlərdən biridir.
Google Saytı Necə Tarayır?
Crawl budget-i anlamaq üçün Googlebot-un işləmə prinsipini bilmək lazımdır.
Googlebot müntəzəm olaraq internetdəki saytları gəzir. Bir səhifəyə gəldikdə həmin səhifədəki bütün linkləri tapır, bu linkləri növbəyə əlavə edir. Növbədəki linkləri prioritetə görə sıralayır — daha önəmli görünənlərə əvvəl gedir. Saytın crawl budget-i bitdikdə qalan səhifələri növbəti tarama dövrünə saxlayır.
Bu proses zamanı Googlebot bir sıra qərar verir. Bu URL-i taraya bilərimmi (robots.txt-də blok var mı)? Bu URL-i taramağa dəyərmi (son dəfə nə vaxt taranıb, dəyişib mi)? Bu URL serverə həddindən artıq yük yaradırmı?
Bu qərarların nəticəsi crawl budget-in necə istifadə edildiğini müəyyən edir.
Crawl Budget-ə Təsir Edən Amillər
Crawl budget sabit bir rəqəm deyil — bir sıra amil onu artıra da, azalda da bilər.
Saytın avtoriteti crawl budget-ə birbaşa təsir edir. [Backlink →]-ləri güclü, Domain Authority-si yüksək, uzun tarixə sahib saytlar daha yüksək crawl budget alır. Google etibarlı saytları daha tez-tez, daha dərindən taramaq istəyir.
Yeniləmə tezliyi crawl demand-ı artırır. Hər gün yeni məzmun əlavə edən saytı Google daha tez-tez taramaq istəyir. Statik, uzun müddətdir dəyişməyən sayta isə az tarama resursu ayrılır.
Server sürəti crawl rate limit-ə birbaşa təsir edir. Yavaş server Googlebot-u geri çəkilməyə məcbur edir — crawl rate aşağı düşür, az səhifə taranır. Sürətli, stabil server daha sürətli taramağa imkan verir.
Saytın ölçüsü nisbətən crawl budget-in istifadəsini müəyyən edir. 100 səhifəlik saytın bütün crawl budget-i tam istifadəsi asandır. 1 milyon səhifəlik saytda isə crawl budget diqqətlə idarə edilmədikdə vacib səhifələr taranmaya bilər.
Keyfiyyətsiz URL-lər crawl budget-i israfçı şəkildə xərclədir. Dublikat məzmun, parametrli URL-lər, sonsuz axtarış kombinasiyaları — bunlar Googlebot-u əhəmiyyətsiz URL-lərin labirentinə salır.
İndekslənmə vəziyyəti crawl demand-a təsir edir. Saytınızda çoxlu indexlənməmiş, ya da zəif performanslı səhifə varsa Google onları daha az tararaq “bu sayt o qədər dəyərli deyil” siqnalı alır.
Crawl Budget Problemlərinin Əlamətləri
Crawl budget problemi olan saytlarda bir sıra simptom müşahidə olunur. Bunları erkən aşkarlayan [SEO audit →] ciddi indekslənmə problemlərinin qarşısını alar.
Yeni məzmunun gec indekslənməsi ilk əlamətdir. Yeni blog yazısı yazdınız, lakin Google bunu həftələrlə indeksləmirmi? Bu crawl budget probleminə işarə ola bilər. Normal hallarda keyfiyyətli saytlarda yeni məzmun 1-3 gündə indekslənir.
Mühüm səhifələrin indeksə düşməməsi ciddi problemdir. Google Search Console-da “İndekslənməyib” kateqorisindəki vacib səhifələr çoxdursa, crawl budget onlara çatmaya bilər.
“Crawled — currently not indexed” statusu — Google bu səhifəni taradı, lakin indeksə əlavə etmədi. Bu bəzən keyfiyyət problemi, bəzən isə crawl budget problemi ilə əlaqəlidir.
Log faylı analizindəki boşluqlar — server log fayllarında Googlebot-un uzun müddət müəyyən bölmələri taramadığı görünürsə, bu crawl budget-in həmin bölmələrə çatmadığına işarədir.
Saytın böyük bölmələrinin indeksdə olmaması — SEO audit zamanı saytda 10.000 URL varsa, lakin Google-da cəmi 2.000-i görünürsə — bu ciddi crawl budget probleminə işarədir.
Crawl Budget-i Optimallaşdırmaq: Praktik Taktikalar
Robots.txt ilə Taramanı İdarə Edin
Robots.txt faylı Googlebot-a hansı URL-ləri taraması, hansılarını tarama-ması barədə təlimat verir. Crawl budget optimallaşdırmasının ən güclü alətlərindən biridir.
Hansı URL-lər robots.txt ilə bloklanmalıdır? Administrativ panellər (/admin/, /wp-admin/ kimi), daxili axtarış nəticə səhifələri (?search= parametrli URL-lər), dublikat məzmun yaradan filtr URL-ləri (?sort=price&order=asc kimi), istifadəçi sessiyası URL-ləri (?sessionid= parametrli), test səhifələri və staging mühiti.
Lakin diqqət — robots.txt ilə bloklanan URL indekslənmir, lakin bu URL-ə daxili linklərdən keçən PageRank boşa gedir. Buna görə robots.txt bloku ilə canonical teq ya da noindex direktivi arasında düzgün seçim etmək vacibdir.
XML Sitemap-i Optimallaşdırın
XML sitemap Google-a saytınızın ən vacib URL-lərini göstərən xəritədir. Düzgün qurulmuş sitemap crawl budget-in ən dəyərli səhifələrə yönləndirilməsini asanlaşdırır.
Sitemap-ə yalnız indekslənməsini istədiyiniz URL-lər daxil edilməlidir. Noindex direktivi olan səhifələr, redirect olan URL-lər, dublikat məzmun olan səhifələr sitemap-dən çıxarılmalıdır. Sitemap-i Google Search Console-a göndərmək — Google-un saytınızı daha sürətlə taramasını sürətləndirir.
Böyük saytlar üçün sitemap indeksi — bir neçə sitemap faylının bir indeks faylında birləşdirilməsi — tövsiyə edilir. Hər sitemap maksimum 50.000 URL əhatə edə bilər.
Dublikat Məzmunu Aradan Qaldırın
Dublikat məzmun crawl budget-in ən böyük israfçısıdır. Google eyni məzmunu fərqli URL-lərdə tapanda hər iki URL-i taramağa çalışır — bu crawl budget-i iki dəfə xərcləyir.
Dublikat məzmunun ən geniş yayılmış səbəbləri bunlardır. WWW və non-WWW versiyaları — example.com və www.example.com eyni məzmunu göstərirsə, biri canonical edilməlidir. HTTP və HTTPS versiyaları — hər ikisi aktiv olduqda dublikat yaranır. Trailing slash problemi — /page/ və /page eyni məzmunu göstərə bilər. Parametrli URL-lər — ?color=red, ?color=blue kimi parametrlər eyni məhsul səhifəsinin fərqli URL-lərini yaradır.
Canonical teq bu problemin həllidir. <link rel="canonical" href="tercih edilən URL"> kodu Google-a hansı URL-in əsas olduğunu bildirir. Canonical teq olan URL-ə crawl resursları yönləndirilir, dublikat URL-lər isə tarama resursunu boşa xərcləmir.
Noindex Direktivi ilə Lazımsız Səhifələri İdarə Edin
Robots.txt hər zaman düzgün seçim deyil — bəzən noindex direktivi daha uyğundur. Noindex <meta name="robots" content="noindex"> HTML kodu vasitəsilə tətbiq olunur.
Noindex hansı hallarda istifadə edilməlidir? Keyfiyyətsiz, az məzmunlu səhifələr üçün — thin content sayfalar crawl budget israf edir. Teqlər, kateqoriyalar, arşiv səhifələri kimi struktural dublikat səhifələr üçün. Paginasiya səhifələri — /page/2/, /page/3/ kimi — bəzi hallarda noindex tövsiyə edilir. İstifadəçi hesabı səhifələri, alış-veriş arabası, ödəniş tamamlanma səhifələri üçün.
Daxili Link Strukturunu Optimallaşdırın
Daxili linklər Googlebot-un saytı necə gəzdiyini birbaşa müəyyən edir. Vacib səhifələrə çoxlu daxili link varmı? Googlebot o səhifəyə daha tez çatar. Vacib səhifə daxili linklərdən kəsilmiş “orphan page” halındadırsa — Googlebot onu tapa bilməyə bilər.
Crawl budget optimallaşdırması üçün daxili link strategiyası belədir. Ən vacib səhifələrə ən çox daxili link verin. Köhnəlmiş, silinmiş URL-lərə aparan qırıq daxili linkləri düzəldin — hər qırıq link crawl budget israfıdır. Çox dərin URL strukturundan — /kateqoriya/alt-kateqoriya/alt-alt-kateqoriya/məhsul/ kimi — qaçının. 3-4 click dərinliyi optimal sayılır. Saytın bütün vacib bölmələri ana səhifədən əlçatan olmalıdır.
Server Performansını Artırın
Server yavaşdırsa Googlebot geri çəkilir — crawl rate aşağı düşür, az səhifə taranır. Server performansı crawl budget-in ən dolayı yolla, lakin ən effektiv şəkildə artırılması yoludur.
Veb Sayt yüklənmə sürəti SEO -nun həm sıralama, həm crawl budget baxımından kritik [KPI →]-larından biridir. Google PageSpeed Insights-ın tövsiyələrini həyata keçirmək — sürəti artırmaq, Core Web Vitals-ı yaxşılaşdırmaq — eyni anda həm istifadəçi təcrübəsini, həm crawl budget-i müsbət yönündə dəyişdirir.
CDN (Content Delivery Network) istifadəsi server yükünü azaldır, yüklənmə sürətini artırır. Keşləmə — server-side caching, browser caching — Googlebot-un hər ziyarətdə serveri yormasının qarşısını alır.
Redirect Zəncirlərini Minimuma Endirin
Redirect (yönləndirmə) Googlebot-un bir URL-dən digərinə keçməsini tələb edir. Hər redirect crawl budget-dən pay xərcləyir. Redirect zəncirləri — A→B→C→D kimi bir neçə mərhələli yönləndirmə — həm crawl budget, həm sürət baxımından zərərlidir.
301 redirect — daimi yönləndirmə — lazımlı hallarda istifadə edilməlidir. Lakin köhnə, artıq aktual olmayan redirect-lər mütəmadi təmizlənməlidir. Əgər A→B→C redirect zənciriniz varsa, bunu birbaşa A→C-yə çevirmek həm crawl budget-i qoruyur, həm link gücünü birbaşa ötürür.
Log Faylı Analizini Aparın
Log faylı analizi crawl budget optimallaşdırmasının ən dərin, lakin ən az istifadə edilən metodudur. Server log faylları Googlebot-un saytınızı necə taradığını tam şəkildə göstərir.
Log faylı analizindən aşağıdakı məlumatları əldə etmək mümkündür. Googlebot ən çox hansı URL-ləri tarayır? Vacib URL-lər kifayət qədər tez-tez taranırmı? Hansı URL-lər crawl budget-i israf edir (çox taranır, lakin dəyərsizdir)? Googlebot-un sayta ilk girişi hansı URL-dən başlayır?
Screaming Frog Log File Analyser, Splunk, ELK Stack — log faylı analizi üçün istifadə edilən əsas alətlərdir. Böyük saytlar üçün bu analiz aylıq aparılmalıdır.
Google Search Console ilə Crawl Budget-i İzləmək
Google Search Console crawl budget idarəetməsi üçün ən vacib pulsuz alətdir. Bir neçə bölmə xüsusilə diqqət tələb edir.
Settings > Crawl Stats bölməsi Googlebot-un saytınızı son 90 gün ərzindəki tarama statistikasını göstərir. Günlük tarama sorğuları, yüklənmə vaxtı, taranmış URL sayı — bunları izləmək crawl budget-in necə istifadə edildiyini göstərir. Ani düşüş saytda texniki problem, ani artış isə yeni böyük məzmun əlavəsinə ya da crawl budget artımına işarə edə bilər.
Index > Pages bölməsi indekslənmiş, indekslənməmiş, xəta olan səhifələri göstərir. “Discovered — currently not indexed” — Google URL-i tapıb, lakin hələ taramayıb — bu crawl budget probleminin birbaşa əlamətidir. “Crawled — currently not indexed” — Google taradı, lakin indeksə əlavə etmədi — bu keyfiyyət problemini göstərir.
Sitemaps bölməsindən sitemap-larınızı göndərə, sitemap vasitəsilə göndərilmiş URL-lərin neçəsinin indeksləndiğini görə bilərsiniz.
Crawl Budget və SEO Arasındakı Əlaqə
Crawl budget birbaşa SEO performansına təsir edir. Bu əlaqəni anlamak crawl budget optimallaşdırmasının niyə bu qədər vacib olduğunu izah edir.
İndekslənmə vaxtı — crawl budget yetərli olmadığında yeni məzmun gec indekslənir. Gec indekslənən məzmun gec sıralanır — bu kontent marketinq strategiyasının effektivliyini azaldır.
Sıralama keyfiyyəti — Google vacib səhifələri tez-tez taradıqda bu səhifələrdəki yeniləmələri daha sürətlə görür. Daim yenilənən səhifələr — qiymət dəyişikliyi, yeni rəylər, yeni məlumat — tez taranmadıqda axtarış nəticəsindəki məlumat köhnə qalır.
Link gücü ötürülməsi — backlink -lər vasitəsilə sayta gələn link gücü yalnız taranmış səhifələrə ötürülür. Taranmayan səhifələr bu gücü ala bilmir.
Texniki SEO audit tərəfindən nəzərə alınması — professional SEO audit crawl budget analizini mütləq əhatə etməlidir. Böyük saytlarda crawl budget problemi olmadan digər SEO işlərinin tam nəticə verməsi mümkün deyil.
Real Nümunə: Crawl Budget Optimallaşdırması Necə Nəticə Dəyişdirir?
Bakıda fəaliyyət göstərən böyük bir e-commerce platforması düşünün. 150.000 məhsul URL-i, 50.000 kateqoriya URL-i, filtrlər nəticəsinde yaranan 800.000 parametrli URL — cəmi 1 milyondan çox URL. Lakin bu saytın real dəyərli URL sayı — unikal məhsul, unikal kateqoriya — cəmi 200.000 idi.
Crawl budget analizindən məlum oldu ki, Googlebot gününlük tarama kapasitesinin 70%-ni parametrli URL-lərə xərcləyirdi. Vacib məhsul səhifələrinin yalnız 40%-i aylıq taranırdı. Yeni məhsulların indekslənmə müddəti ortalama 3-4 həftə idi.
Görülən işlər: parametrli URL-lər robots.txt ilə bloklandı, canonical teqlər bütün filtrlı URL-lərə əlavə edildi, sitemap yalnız real dəyərli 200.000 URL-i əhatə edəcək şəkildə yeniləndi, server performansı gücləndirildi.
6 ay sonra nəticə: Googlebot günlük tarama kapasitesinin 85%-ni real dəyərli URL-lərə xərcləməyə başladı. Yeni məhsulların indekslənmə müddəti 3-4 həftədən 2-3 günə endi. Üzvi trafik 35% artdı — çünki daha çox vacib səhifə daha tez indeksləndi, daha tez sıralandı.
Azərbaycanda Crawl Budget
Azərbaycanda crawl budget anlayışı hələ çox az SEO mütəxəssisi tərəfindən tam anlaşılır. Böyük e-commerce platformaları, xəbər portalları, kataloq saytları bu problemlə rastlaşır, lakin səbəbini çox zaman aşkarlaya bilmirlər.
Azərbaycan bazarında crawl budget probleminin ən geniş yayılmış səbəbləri bunlardır. E-commerce saytlarında filtr kombinasiyaları — rəng, ölçü, qiymət — milyonlarla parametrli URL yaradır. Çoxdilli saytlar — Azərbaycan, Rus, İngilis dilləri — hər dil üçün ayrı URL strukturu yaradır, düzgün hreflang olmadan dublikat problem yaranır. Köhnə CMS sistemlər — pagination, teq, kateqoriya URL-lərini düzgün idarə etmir.
Crawl Budget üçün Yoxlama Siyahısı
Crawl budget-i optimallaşdırmaq üçün aşağıdakı addımları mütəmadi yoxlayın. Google Search Console-da Crawl Stats hesabatını aylıq nəzərdən keçirin. Robots.txt faylının düzgün konfiqurasiya edildiyini yoxlayın. XML sitemap-da yalnız indekslənməsini istədiyiniz URL-lər olduğunu yoxlayın. Parametrli URL-lərin canonical ya da robots.txt ilə idarə edildiyini yoxlayın. Redirect zəncirlərini tapın və sadələşdirin. Daxili qırıq linkləri müəyyən edib düzəldin. Server yüklənmə sürətini PageSpeed Insights ilə ölçün. Log faylı analizindən Googlebot davranışını izləyin.